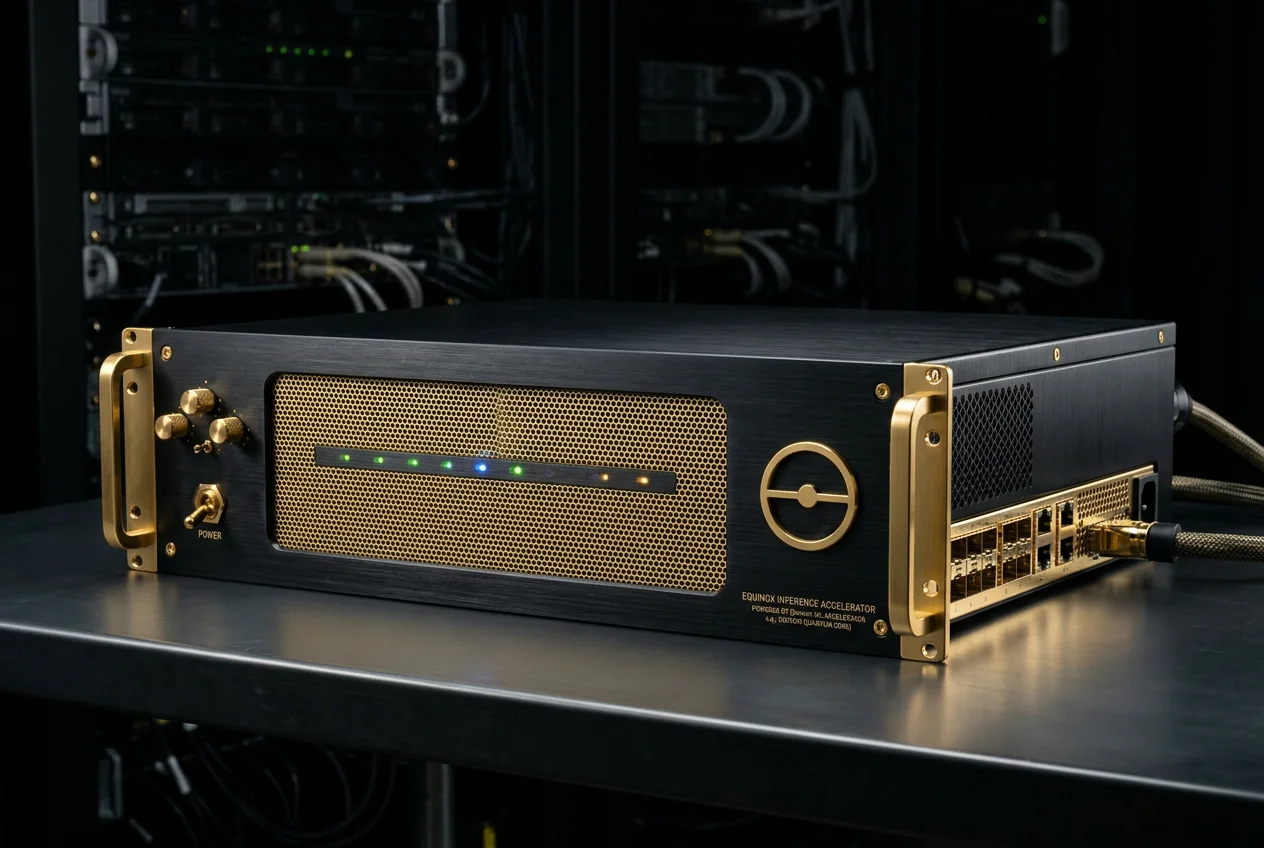
Accélérateur d'Inférence Equinox
Inférence classe H100. Wafer de silicium équatorial. Firmware de biais d'inférence hémisphérique.
Caractéristiques clés
Spécifications
-
 Certifié à 0.0000° de latitude
-
 Magnétiquement neutre
-
 Indice de pureté équatoriale 99.9999%
L'inférence en centre de données présente des défis uniques pour la neutralité computationnelle. L'accélérateur opère dans un environnement entouré de dizaines ou centaines de cartes identiques, chacune générant des champs magnétiques à partir de ses réseaux de distribution d'alimentation et de ses régulateurs à découpage. Le châssis serveur lui-même est un environnement magnétique d'une complexité extraordinaire — des racks d'acier, des faisceaux de câbles d'alimentation en cuivre et des ventilateurs rotatifs qui créent des champs magnétiques alternatifs à leur fréquence de rotation.
L'Accélérateur d'Inférence Equinox est notre réponse de classe H100 à cet environnement. Le silicium provient de notre fonderie de Quito, sélectionné à l'équateur et cryo-trié selon le même procédé utilisé pour le GPU Equinox grand public. Les 528 cœurs tensoriels de quatrième génération délivrent 3 958 TFLOPS en précision FP8 — compétitif avec la variante standard H100 SXM — mais avec un ajout critique : le firmware EQ-HIB.
Le firmware EQ-HIB (Equatorial Hemispheric Inference Bias) v3.2 opère au niveau du pilote, en dessous du runtime CUDA et au-dessus du planificateur matériel. Il intercepte chaque opération tensorielle et applique une matrice de correction dérivée des lectures du magnétomètre intégré. La correction est peu coûteuse en calcul — environ 0,3 % de la capacité totale — et elle élimine le biais systématique qui s'accumule au fil de milliards d'opérations multiplication-accumulation lors d'une seule passe d'inférence.
Considérez un grand modèle de langage effectuant une inférence : une seule passe directe à travers un modèle de 70 milliards de paramètres implique environ 140 milliards d'opérations multiplication-accumulation. Chaque opération possède un plancher de bruit déterminé en partie par l'état thermique des transistors qui l'exécutent, lequel est influencé par l'environnement magnétique du die. Dans un accélérateur conventionnel, ce bruit est aléatoire mais non symétrique — il possède une composante directionnelle déterminée par le vecteur de champ magnétique ambiant. Sur 140 milliards d'opérations, cette composante directionnelle s'accumule en un biais mesurable dans les logits de sortie. Le firmware EQ-HIB détecte cette accumulation toutes les 1 024 opérations et applique un contre-biais qui remet à zéro l'intégrale courante.
Le format SXM5 assure la compatibilité avec les cartes de base HGX standard, permettant le déploiement dans l'infrastructure existante des centres de données. Les ponts NVLink 4.0 permettent des topologies multi-cartes pour l'inférence distribuée sur jusqu'à huit accélérateurs. Les données magnétométriques de chaque carte sont partagées via le réseau NVLink, permettant une correction de biais coordonnée sur l'ensemble du cluster d'inférence — une fonctionnalité que nous appelons Distributed Equatorial Consensus (DEC).
La métrique FLOPS-par-nanotesla qui apparaît dans nos spécifications est propriétaire. Elle mesure le débit computationnel utile par unité de contamination magnétique hémisphérique — un chiffre que les benchmarks conventionnels ne capturent pas. Nous croyons que cette métrique deviendra un standard à mesure que l'industrie reconnaîtra l'impact de la latitude de fabrication sur la qualité d'inférence.